阅读主题
第 2 章:ID 不只是数据库主键
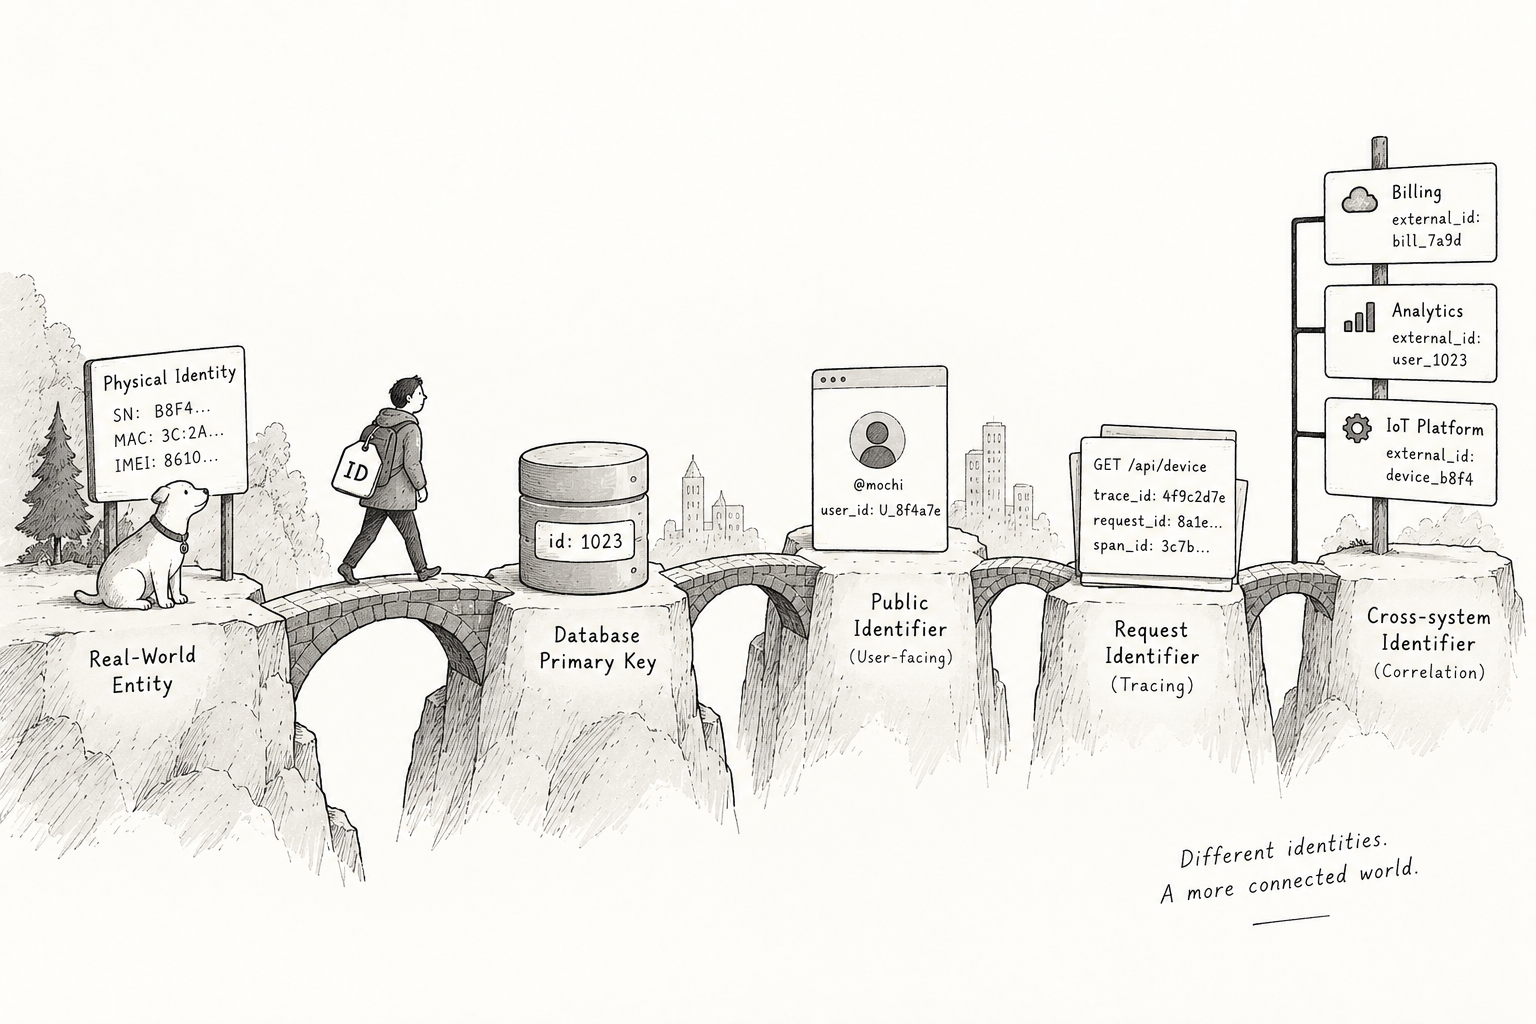
同一个对象会穿过存储、接口与外部系统;每一段标识都承担不同的识别责任。
开发一个功能时,ID 往往只是数据表里的一列:给待办事项、用户、文件或订单找一个编号。数据库需要它定位一行,接口需要它把对象传来传去,日志需要它把几次操作串起来。因为这些地方都出现了同一个数字或字符串,我们很容易以为它们指的是同一件事。
离线待办应用很快会暴露这个假设。手机还没有联网,电脑也刚刚装好应用。你在手机上写下“买牛奶”,在电脑上写下“给房东发消息”。两个设备都从本地的第一条记录开始编号,于是都生成了 id = 1。网络恢复后,应用尝试把两边的数据同步到一起。如果它只按这个编号判断是否为同一条待办,就可能把电脑上的“给房东发消息”当作手机上“买牛奶”的新内容,用一条覆盖另一条。
代码并没有违反各自设备上的规则。问题在于,1 只在本地存储里唯一,却被同步逻辑当成了所有设备都认可的身份。数据库主键能够定位一条记录,不等于它已经定义了业务对象的身份。 要解决这个问题,我们需要说明:这个标识识别谁,在哪个范围内唯一,换了存储位置后是否仍然稳定,以及哪些系统或用户可以看到它。
这些问题还会在没有离线同步的系统里出现。自增编号可能因为分库而只在局部成立;一个可读的订单号可能适合客服沟通,却不适合当作内部主键;一次请求的编号需要识别调用,而不是识别它操作的对象。标识看起来都是字符串,生命周期和保证却并不相同。
因此,选择自增 ID、UUID 或其他生成方式以前,我们要先把身份、位置、表示和请求分开。随后才能判断唯一性需要覆盖多大的边界,哪些值可以重新生成,哪些值必须穿过迁移、导入和重建继续保持稳定。本章会从这些语义区别出发,再回到常见实现和一个完整的订单设计。
本章阅读路径
本章先区分实体身份、数据库主键、公开标识、请求标识和跨系统关联标识,回答“这个 ID 究竟识别什么”;随后建立唯一性范围、稳定性、可预测性、可读性、生成位置和生命周期这些比较维度。
在此基础上,我们比较自增整数、UUID、Snowflake 一类的结构化标识,以及与内部身份分离的业务编号。接着讨论标识出现在 URL、日志和客户端数据中时意味着什么,说明不可枚举不能替代认证与授权。
后半部分把这些约定放进迁移、合并、重建和跨设备同步的场景,解释旧新 ID 映射、别名和来源标识分别解决什么问题。最后用一次支付请求把实体 ID、请求 ID、幂等键和外部交易号放在同一条证据链上,并通过设计练习检查一套标识方案是否自洽。
阅读本章时,可以反复追问五件事:它识别的对象是什么?唯一性在哪个边界内成立?对象搬家后什么必须不变?这个值暴露后会带来什么承诺?事后如何把不同系统中的记录重新关联起来?